Köra AI lokalt på datorn 2026: så kommer du igång nu
Köra AI lokalt betyder att en språkmodell körs på din egen dator. Så mycket minne behövs, vilka öppna modeller som finns och hur du startar med Ollama.
Att köra AI lokalt betyder att språkmodellen ligger och räknar på din egen dator i stället för på en leverantörs servrar. Du installerar ett program, hämtar en modell som en stor fil och chattar med den, utan konto och utan att texten skickas till någon.
Det går, men det kräver rätt förväntningar. Det som sätter gränsen är minnet, inte själva installationen, och modellerna som ryms på en vanlig dator är mindre än de som driver ChatGPT eller Gemini. Jag har gått igenom dokumentationen för Ollama och LM Studio, modellkorten för de öppna modellerna och Microsofts utvecklarguide om NPU:er för att skilja det som är belagt från det som är hype.
Vad är en lokal språkmodell?
En lokal språkmodell är en språkmodell vars filer ligger på din dator och som körs där. Ett program läser in modellens vikter, alltså de inlärda talen, i minnet och räknar fram svaret. Det finns inget abonnemang bakom, bara filen och ett program som kan köra den.
Skillnaden mot en tjänst är var beräkningen sker. ChatGPT körs på OpenAI:s servrar, medan öppna modeller kan hämtas och köras av vem som helst. Grunderna i vad en språkmodell gör finns i vad är ChatGPT.
Två program gör det enkelt. Ollama körs i terminalen och finns för macOS, Linux och Windows. LM Studio har ett grafiskt gränssnitt med en flik för att söka modeller och en för att chatta.
Varför köra AI lokalt, och vad kostar det i kvalitet?
Skälen är integritet, offline-användning och att slippa en löpande kostnad per tjänst. Priset är att modellen är mindre än de stora tjänsternas och att din dator måste orka med den. För känslig text kan det vara värt det, för svåra uppgifter ofta inte.
Integritet är det starkaste argumentet. Ollamas FAQ skriver att de inte ser dina prompter eller data när du kör lokalt. Hur de stora tjänsterna hanterar dina data går vi igenom i AI och dataskydd. Lokal körning tar bort överföringen till en leverantör, men reglerna om personuppgifter gäller ändå, vilket GDPR och ChatGPT beskriver.
Offline fungerar också. LM Studio skriver att programmet kan köras helt utan internet när modellfilerna väl är hämtade. Sökning efter modeller, nedladdningar och uppdateringar kräver däremot uppkoppling.
Begränsningen ska sägas rakt ut. Modellerna som ryms på en privatdator har några miljarder till drygt trettio miljarder parametrar, och de större versionerna kräver mer minne än de flesta har. OpenAI:s gpt-oss-120b behöver till exempel en enskild 80 GB-GPU enligt modellkortet. Räkna med att svåra uppgifter och långa dokument blir sämre än i de stora tjänsterna, och prova dina egna uppgifter först.
Hur mycket minne behöver du för att köra en språkmodell lokalt?
Modellens vikter måste få plats i minnet, och kontexten du skriver in tar mer ovanpå. Som tumregel krymper vikterna till ungefär hälften i 8-bitarsformat och en fjärdedel i 4-bitarsformat jämfört med BF16. Googles tabell för Gemma 4 visar det: modellen på 31 miljarder parametrar går från 69,9 GB till 17,5 GB.
Det är kvantisering. Hugging Face beskriver tekniken som att representera värdena med datatyper med lägre precision, vilket kräver mindre minne.
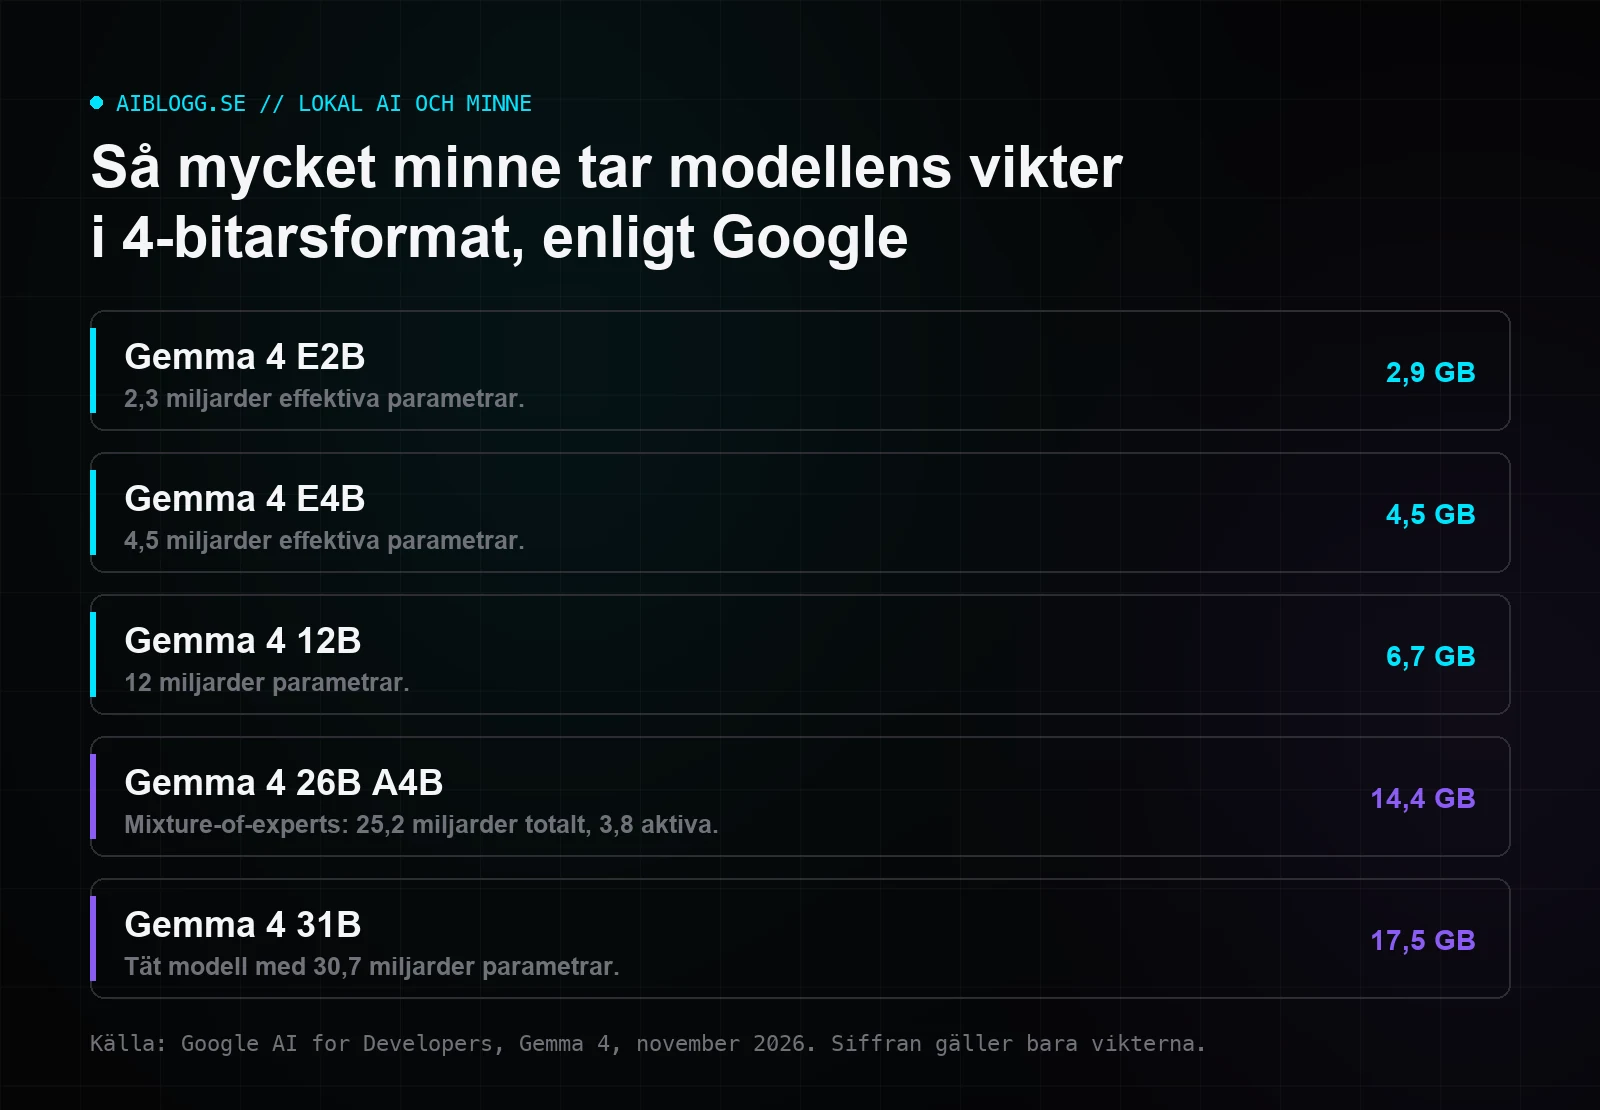
Mistrals modellkort för Mistral Small 3.2 med 24 miljarder parametrar säger att modellen kräver cirka 55 GB GPU-minne i bf16 eller fp16, alltså i samma storleksordning som två byte per parameter.
Kontexten räknas separat. Ollamas standardlängd är 4096 tokens, och längre kontext ger ett större cache-minne. Ollamas FAQ nämner att du kan kvantisera cachen för att spara minne, där q8_0 enligt dem tar ungefär hälften av f16 med liten kvalitetsförlust.
Vad som räknas som minne beror på datorn. På Windows och Linux är det grafikkortets VRAM som ger fart, och LM Studio rekommenderar minst 4 GB eget VRAM på Windows samt minst 16 GB RAM. På Mac med Apple Silicon delar processor och grafik på samma minne, och LM Studio rekommenderar minst 16 GB, men skriver att 8 GB går med små modeller och måttlig kontext. Ryms inte modellen helt i VRAM delar Ollama upp den mellan GPU och systemminne, vilket ollama ps visar som till exempel 48 procent CPU och 52 procent GPU. Det fungerar men är långsammare.
Vilka öppna modeller kan du köra, och vad säger licensen?
Det finns flera familjer med öppna vikter, och de flesta ligger under Apache 2.0 som tillåter fri användning och vidareutveckling. Llama är det tydligaste undantaget, med en egen licens och egna villkor. Läs licensen på modellkortet för den version du hämtar.
Det här har jag läst på modellkorten och licenssidorna i november 2026:
- Gemma 4 (Google): Hugging Face-kortet för gemma-4-31B-it anger licensen apache-2.0.
- gpt-oss (OpenAI): gpt-oss-20b är licensierad under Apache 2.0, har 21 miljarder parametrar varav 3,6 miljarder aktiva och kan enligt kortet köras inom 16 GB minne tack vare MXFP4-kvantisering.
- Mistral Small 3.2 (Mistral): licensen är apache-2.0 och modellen har 24 miljarder parametrar.
- Qwen3 (Alibaba): Qwen3-30B-A3B är licensierad under Apache 2.0.
- Llama 3.3 (Meta): har en egen licens, Llama 3.3 Community License. Den kräver bland annat att du ber Meta om licens om dina tjänster hade mer än 700 miljoner aktiva användare per månad, att du visar “Built with Llama” om du distribuerar och att du följer Metas policy för godtagbar användning.
Någon rankning av vilken modell som är bäst ger jag inte. Det byter nästan varje månad, och det som avgör för dig är vad som ryms i ditt minne och hur modellen beter sig på dina uppgifter.
Hur kommer du igång med Ollama eller LM Studio?
Installera programmet, hämta en modell som ryms i minnet och börja chatta. Med Ollama gör du det i terminalen med ett kommando, med LM Studio genom flikarna Discover och Chat. Båda lägger modellfilen på din disk, och efter nedladdningen kan du koppla ned internet.
Med Ollama:
- Hämta programmet på ollama.com/download. Det finns för macOS, Linux och Windows.
- Öppna terminalen och skriv
ollama run gemma4:e2b. Kommandot hämtar modellen och startar en chatt. Nedladdningen är enligt Ollamas snabbstart ungefär 7,2 GB, och sidan rekommenderar 8 GB VRAM eller delat minne på Mac. - Avsluta chatten med
/bye. Servern svarar sedan påhttp://localhost:11434, så att andra program på datorn kan använda modellen. Ingen API-nyckel behövs för lokala modeller, enligt Ollama.
Med LM Studio:
- Installera programmet. Kraven är en Mac med Apple Silicon och macOS 14 eller nyare, eller en Windows-dator med x64 och AVX2 respektive Snapdragon X Elite. Intel-Mac stöds inte, enligt systemkravssidan.
- Öppna fliken Discover, sök på modellnamnet och hämta den.
- Gå till fliken Chat, välj modellen i laddaren och börja skriva.
Vad gör en NPU i en Copilot+ PC för lokal AI?
En NPU är en processor byggd för AI-beräkningar som är energisnål, men den gör inte datorn bra på stora språkmodeller av sig själv. Microsoft skriver att programvaran måste vara skriven för NPU:n och att modellerna ofta måste konverteras till lägre precision för att köras på den.
Microsofts utvecklarguide definierar en Copilot+ PC som en Windows 11-dator med en NPU som klarar mer än 40 TOPS. De AI-funktioner i Windows som är gjorda för NPU:n, som Recall och översättning i livetextningen, drar nytta av den. Guiden skriver också att NPU:n ger längre batteritid och snabbare svar för modeller som är anpassade för den.
För dig som vill köra Ollama eller LM Studio är det modellens minnesbehov som sätter gränsen, inte antalet TOPS. Jag har inte sett att något av programmens dokumentation som jag läst lovar att en NPU ger snabbare chatt, så kontrollera det i programmets egen dokumentation innan du köper en dator för NPU:ns skull. Kraven och vem som har nytta av märkningen går vi igenom i guiden om Copilot+ PC. LM Studio listar Windows på ARM med Snapdragon X Elite som stödd arkitektur.
Fungerar lokala modeller på svenska?
Ja, men kvaliteten varierar mellan modeller och storlekar, och modellkorten anger sällan hur bra svenskan är. Gemma 4:s kort nämner stöd för över 140 språk och Qwen3 över 100, men ingen av dem listar svenska vid namn. Testa därför själv på ett sätt som visar skillnaden.
Mistral Small 3.2 anger 24 språk utan att räkna upp dem. Jag kan alltså inte belägga hur bra en viss modell är på svenska. Ett test på tio minuter ger dig svaret för din användning:
- Klistra in en egen text på svenska och be om en sammanfattning. Kontrollera om fakta ändras eller hittas på.
- Be om rättning av en text med medvetna fel i sammansatta ord och i å, ä och ö.
- Översätt ett stycke från engelska till svenska och tillbaka. Låter svenskan som en direktöversättning?
- Ställ en faktafråga om Sverige där du redan kan svaret.
- Skriv “Svara alltid på svenska” som första instruktion och se om modellen håller sig till den.
Kör samma fem uppgifter på två modeller som ryms i ditt minne, och jämför.
För tal finns det en svensk modell med belägg. KBLab vid Kungliga biblioteket har tränat KB-Whisper på över 50 000 timmar svenskt tal, och den är licensierad under Apache 2.0. Enligt KBLab:s egna siffror sänker den ordfelfrekvensen med i genomsnitt 47 procent jämfört med OpenAI:s whisper-large-v3. Det är en modell för att göra tal till text, inte för att chatta, och hur du använder den beskriver transkribera ljud till text.
Vanliga frågor om att köra AI lokalt
Kan jag köra ChatGPT lokalt? +
Behöver jag ett grafikkort för att köra en språkmodell? +
Är lokal AI säkrare än ChatGPT för känsliga uppgifter? +
Fungerar lokal AI utan internet? +
Vad härnäst?
Kolla hur mycket VRAM eller delat minne din dator har, hämta den minsta modellen i en familj du vill prova och kör de fem svenska testuppgifterna. Vill du veta vilka tjänster som är bäst när lokal inte räcker finns bästa AI-verktyg på svenska.
Källor: Ollama, Quickstart, Ollama, FAQ, Ollama, Download, LM Studio, System Requirements, LM Studio, Get started, LM Studio, Offline Operation, Google AI for Developers, Gemma core models, Hugging Face, gemma-4-31B-it, Hugging Face, gpt-oss-20b, Hugging Face, Mistral-Small-3.2-24B-Instruct-2506, Hugging Face, Qwen3-30B-A3B, Meta, Llama 3.3 Community License, Hugging Face, KB-Whisper large, Hugging Face Optimum, Quantization, Microsoft Learn, Copilot+ PCs developer guide.
Mer från aiblogg
Copilot+ PC 2026: vad det är och behöver du en AI-dator?
Copilot+ PC är bärbara datorer med NPU på minst 40 TOPS. Så fungerar kraven, vad Recall gör med dina data och vem som faktiskt har nytta av en AI-dator.
Windows 11 Pro-licens: OEM, retail och begagnad licens 2026
Windows 11 Pro-licens förklarad: vad Pro ger mot Home, hur uppgraderingen går till och vad skillnaden mellan retail, OEM och begagnade nycklar betyder.
AI för smarta hem och renoveringsplanering: så använder du det 2026
AI sorterar offerter, håller koll på budgeten och styr larm, värme och belysning under en renovering. Vi går igenom vad som faktiskt fungerar 2026.